Solo runAI Coding
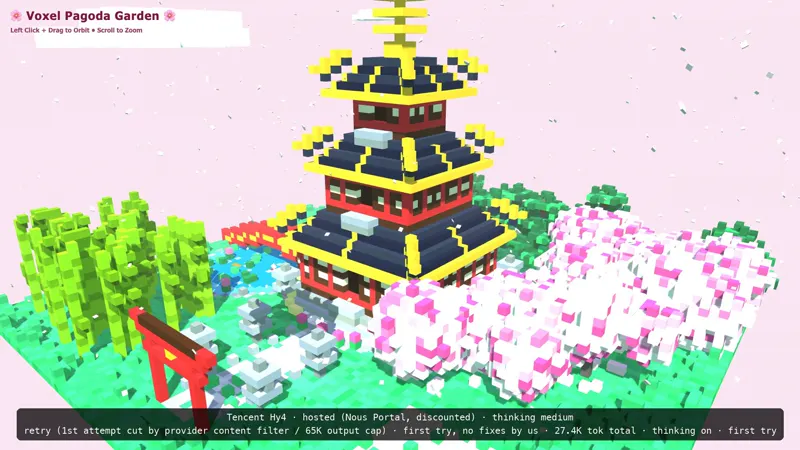
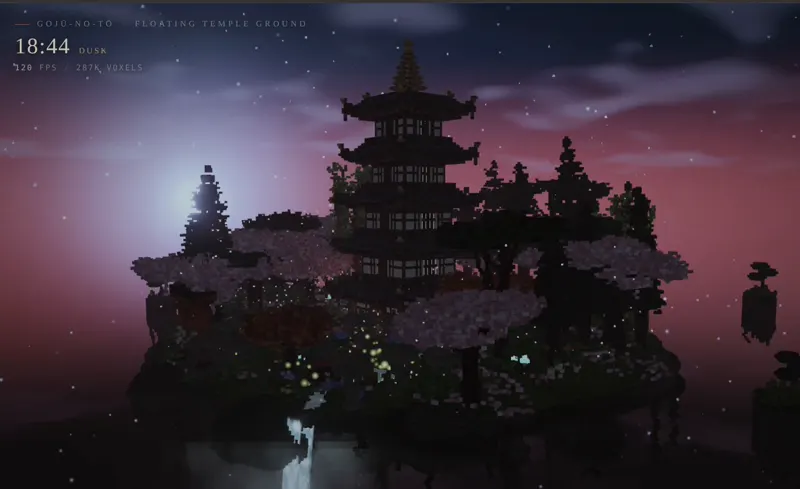
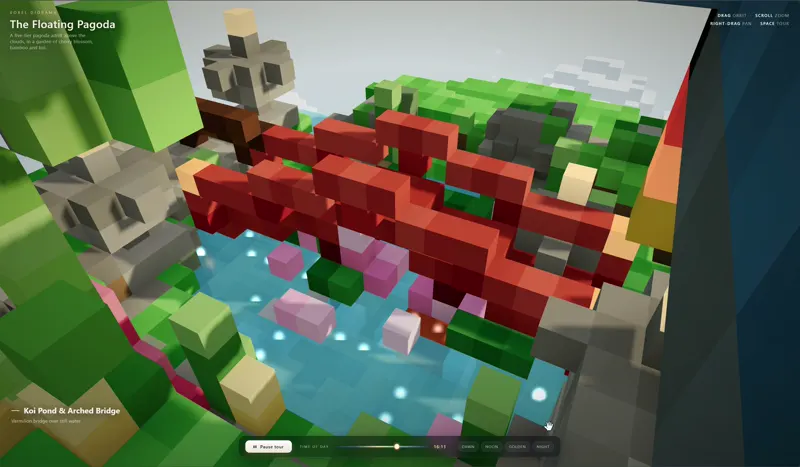
Voxel pagoda, Qwen 3.8 Flash Next on a 5070 Ti — Qwen 3.8 Flash Next

Qwen 3.8 Flash Next (IQ3 quant) runs the voxel pagoda prompt locally on an RTX 5070 Ti with 80 GB of RAM, at 70-80 tokens per second decode.
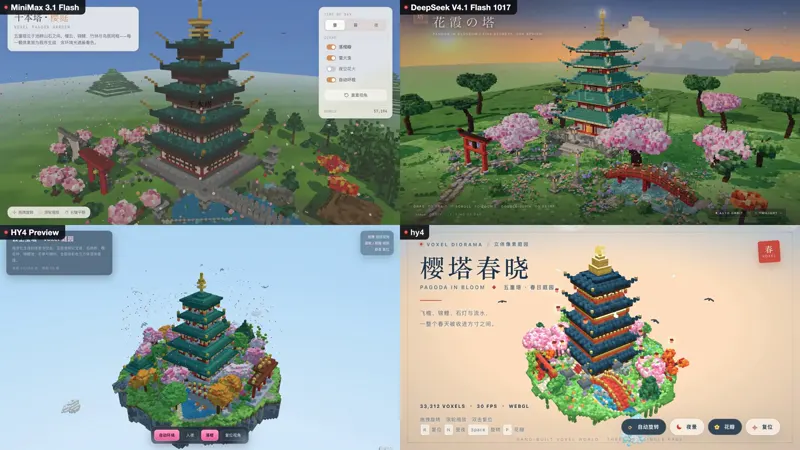
One model’s result, not a side-by-side. See other models on Voxel pagoda garden / Japanese shrine; prompts, tools and time differ, so compare loosely.
The post, itemised
- Kind
- Solo run
- Task
- Voxel pagoda, Qwen 3.8 Flash Next on a 5070 Ti
- Category
- 3D & Shaders
- Mode
- Not stated
- Posted
- Video length
- 29.3 s
- Likes
- 0
- Views
- 10
- Bookmarks
- 0
- Sponsored
- No
Related
Posted by @tabuci88 on X. aivs.tv claims no ownership: it hosts a copy for fast playback and links to the post on X. Request removal